Simulationssoftware für Laser-DED mit Draht oder Pulver
Wir simulieren die ganze Schweißspur in einem Durchlauf.
Die Software bildet Schmelzbad und Schweißspur Lage für Lage ab, mit Ihrer Geometrie und Ihrem Werkstoff. Weil die Schmelze aus frei beweglichen Partikeln besteht, braucht die netzfreie Methode kein Rechengitter, was die Simulationen effizient macht.

Ein Rechengitter, das der Bauteilform folgt, muss kontinuierlich an die sich ändernde Geometrie angepasst werden. Die Partikel wandern dagegen mit dem Material mit und sparen dadurch Rechenzeit.
Links ein Rechengitter, rechts freie Partikel. Während vier Lagen aufgetragen werden, muss nur das Rechengitter links an das wachsende Bauteil angepasst werden; die Partikel folgen dem Material.
Die Partikelmethode SPH
SPH (Smoothed Particle Hydrodynamics) bildet den Werkstoff mit beweglichen Rechenpartikeln ab. Jedes Partikel trägt Temperatur und Phase, fest oder flüssig, und bewegt sich mit der Schmelze. Aus den Wechselwirkungen der Partikel ergeben sich Wärmeübertragung, Schmelzströmung und die Form der freien Oberfläche.
Schema, Illustration
- Prozesseingang
- Laser und Werkstoffzufuhr bestimmen, wie viel Energie und Masse in den modellierten Bereich gelangen.
- Partikelzustand
- Wärmeübertragung und Phasenübergang aktualisieren den Zustand jedes Partikels.
- Freie Oberfläche
- Oberflächenspannung formt die Schmelze. An der Kontaktlinie bestimmt die Benetzung, wie weit die Schmelze sich ausbreitet.
- Geometrie
- Aus dem Partikelfeld ergeben sich Spurbreite, Schichthöhe und Schmelztiefe.
Modellgrößen und Grenzen
Das Modell simuliert auf Spurebene die Schmelzbadströmung und die Geometrie der aufgetragenen Schweißspur. Aus diesen Größen berechnet die Simulation die Parameter entlang der Bahn, die Ihr CAM festlegt. Temperaturverlauf und Verzug des ganzen Bauteils gehören zur CAE auf Bauteilebene.
Schema, Illustration
Das Modell berechnet
- Spurbreite
- wie breit die aufgetragene Schweißspur auf der Oberfläche aufliegt
- Schichthöhe
- wie hoch die Schweißspur über der Oberfläche steht
- Schmelztiefe
- wie tief die Schmelze in den Werkstoff darunter reicht
- Maximale Oberflächentemperatur
- wie heiß das Schmelzbad an der Oberfläche wird
- Das Modell belegt nicht
- Eigenspannung, Bauteilverzug, Mikrostruktur und Prozessfenster außerhalb des Abgleichs.
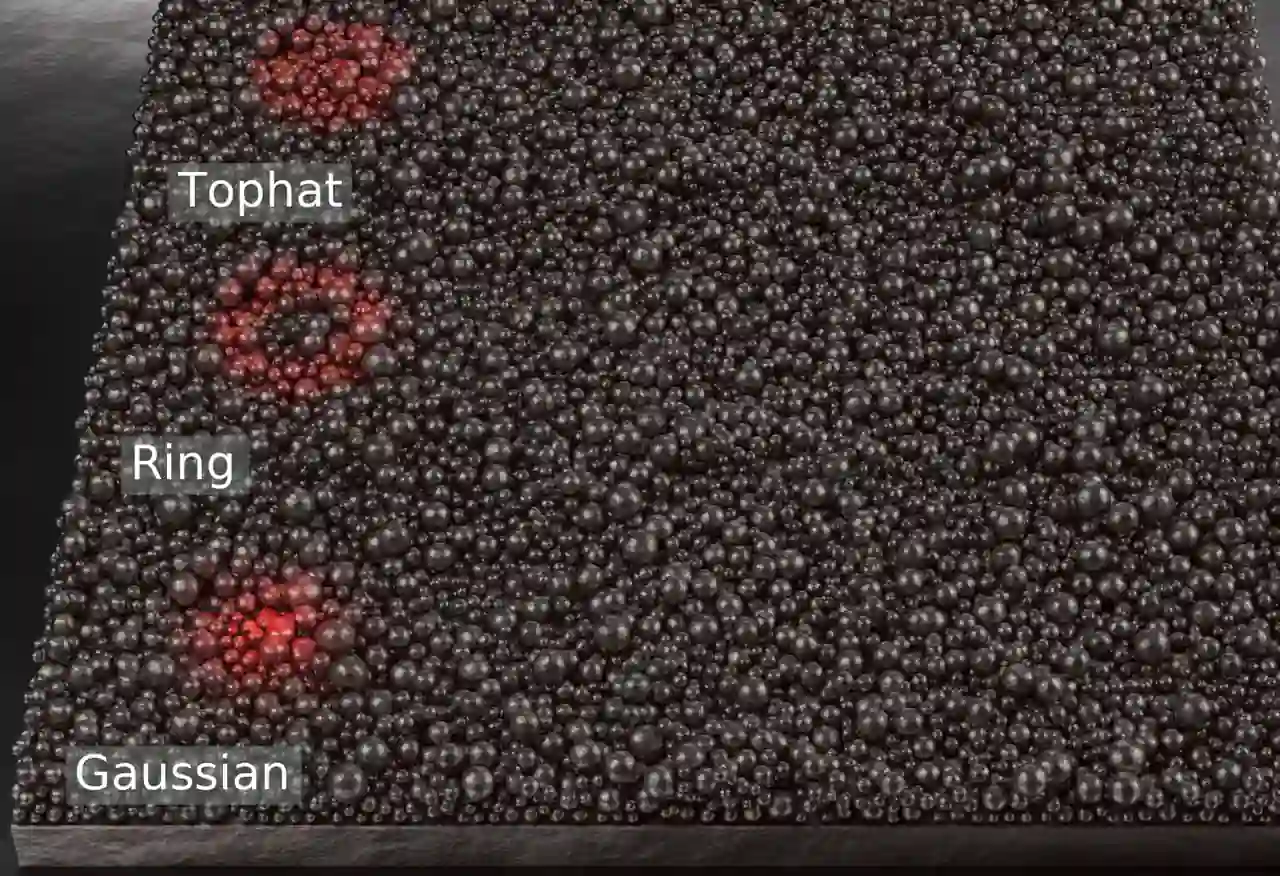
Das Modell nimmt das Strahlprofil als Eingang: Gauß, Ring, Top-Hat.
Ihr Team prüft die angepasste Maschinendatei, fährt den Druck und verantwortet die Qualifizierung von Prozess und Bauteil.
Abgleich mit Experimenten
Der Gründer hat das Modell in seiner Dissertation (2023) für Rein-Titan mit Einzelspur-Experimenten validiert.
Im Pilotprojekt kalibrieren wir das Modell auf Ihre individuelle Maschine, etwa mit einem Querschliff, bis simulierte und experimentelle Ergebnisse bestmöglich übereinstimmen.
Jeder Abgleich nennt die Messungen, mit denen wir kalibriert haben.
Vom CPU-Cluster zur GPU
Grundlage unserer GPU-Software ist ein hochoptimierter CPU-Code. Er verteilt eine Simulation auf viele Knoten eines Rechenclusters und skaliert dabei nahezu linear. Sein Datenlayout für schnellen Speicherzugriff und seine parallele Struktur haben wir auf GPUs übertragen; heute rechnen wir nur noch dort.
Messung, Rechencluster
Normierte Kernzahl r: Zahl der Kerne, geteilt durch die Kerne des kleinsten Laufs. r = 8 heißt achtmal so viele Kerne.
- Innerhalb eines Knotens
- nahezu ideal bei wenigen Kernen, dann bremst die Speicherbandbreite, weil alle Kerne eines Knotens denselben Speicher teilen und auf Daten warten
- Über Knoten hinweg
- jeder Knoten bringt eigenen Speicher mit, daher wieder nahezu linear bis etwa zum Fünfhundertfachen der Kernzahl des kleinsten Laufs, darüber flacher
Gemessen auf einem CPU-Cluster: AMD-EPYC-Knoten mit 128 Kernen, InfiniBand-Verbindung, November 2023
Die Simulation lässt sich auf viele Prozessorkerne verteilen, die gleichzeitig rechnen. Die Beschleunigung gibt an, wie viel schneller ein Lauf ist als der kleinste Lauf. Die normierte Kernzahl r gibt an, wie viele Kerne ein Lauf im Verhältnis zum kleinsten Lauf nutzt. Läge die Kurve auf der Diagonalen, würde jede Verdopplung der Kerne die Rechenzeit halbieren. Über mehrere Knoten, also einzelne Rechner des Clusters, verläuft die Kurve bis etwa r = 512 nahezu parallel zu dieser Diagonalen und flacht erst darüber ab. Die Beschleunigung wächst dort also fast im gleichen Verhältnis wie die Kernzahl, liegt aber unter dem Idealwert.
CPU-Code, optimiert und skaliert
Datenlayout und parallele Struktur übertragen
GPU-Software, heute
Quellen
- Rechengitter und PartikelSchema, Illustration: Synafloat-Methodendarstellung.
Zeigt das Prinzip netzbasiert gegenüber netzfrei. Kein Rechenergebnis.
- Drei StrahlprofileSimulation, Demonstrator: drei Einzelspuren, drei Strahlprofile.
Belegt das Strahlprofil als Eingang des Modells, keinen Vergleich der Profile.
- Beschleunigung über der normierten KernzahlMessung, CPU-Cluster, November 2023: eigene Messreihe.
Belegt die relative Beschleunigung über der normierten Kernzahl.
Belegt die Formulierung von Oberflächenspannung und Benetzung an freien Oberflächen in SPH.
Abgleich des Modells für Rein-Titan mit Einzelspur-Experimenten.
Fachbeiträge
Die Fachbeiträge vertiefen Spurgeometrie und die Wahl des Simulationsverfahrens.
Sprechen wir über Ihr Bauteil
Im Gespräch klären wir, ob die Simulation Ihre Parameterfrage beantwortet.
Gespräch buchenDen Termin wählen Sie auf book.synafloat.com.
Sie sprechen mit Dr. Michael BlankDer Gründer forscht seit 2017 zur partikelbasierten Schmelzbadsimulation und hat darüber promoviert.